Call Overflow Management: So verhindern Sie Anrufüberlastungen
Erfahren Sie, wie das Management von Anrufüberlastungen mit priorisierter Weiterleitung nach Fähigkeiten, Sprachdialogsystem und externer Kapazität für…
Kurz gesagt: Kombinieren Sie priorisiertes Skill‑Routing, ausgebauten Self‑Service über IVR und ein skalierbares Fallback wie externe Overflow‑Kapazität. Das senkt die Abbruchraten am schnellsten und hält gleichzeitig die First Contact Resolution stabil. Als Messbasis dienen Service Level, ASA und Abandon Rate. Kurzfristig zählt technische Konfiguration, mittelfristig zählt Workforce Planning.
Kurz gesagt:
- Bei saisonalen Spitzen und unvorhersehbaren Anrufvolumen empfiehlt sich eine Kombination aus priorisiertem Skill‑Routing, IVR-Self-Service und skalierbaren Fallback-Lösungen, um Abbrüche zu minimieren.
- Technische Systeme wie ACD, IVR und SIP müssen in Echtzeit erkennen, wann Kapazitätsgrenzen erreicht sind, und automatische Fallback-Regeln auslösen.
- Die wichtigsten Kennzahlen für Overflow-Management sind Service Level, ASA, Abandon Rate, First Contact Resolution und Overflow‑Rate, die regelmäßig ausgewertet werden sollten.
- Effektives Workforce Planning mit ausreichend Vorlauf und flexible Personalmodelle senkt die Gefahr von Überlastung und reduziert die Notwendigkeit externer Overflow-Kapazitäten.
- Für eine nachhaltige Optimierung muss die Integration von CRM- und Ticket-Systemen nahtlos funktionieren, um Kontextverluste und wiederholte Kundenkommunikation zu vermeiden.
Was ist Call Overflow Management? Ursachen und operative Implikationen
Call Overflow entsteht, wenn mehr Anrufe eingehen, als die verfügbaren Mitarbeiter in akzeptabler Zeit annehmen können. Das System leitet die überschüssigen Kontakte dann an eine andere Warteschlange, eine externe Nummer oder einen automatisierten Kanal weiter. Genau hier setzt Anrufmanagement Lösungen an: Sie entscheiden, wohin ein Anruf geht, wenn die primäre Queue erschöpft ist.
Die Ursachen sind selten Zufall. Marketingkampagnen mit unerwartetem Response, technische Ausfälle bei anderen Kanälen, saisonale Spitzen im Handel oder schlichte Personalengpässe durch Krankheit treiben das Anrufvolumen über die Kapazitätsgrenze. Auch ein einzelner viraler Social‑Media‑Post kann eine Warteschlange innerhalb von Minuten sprengen.
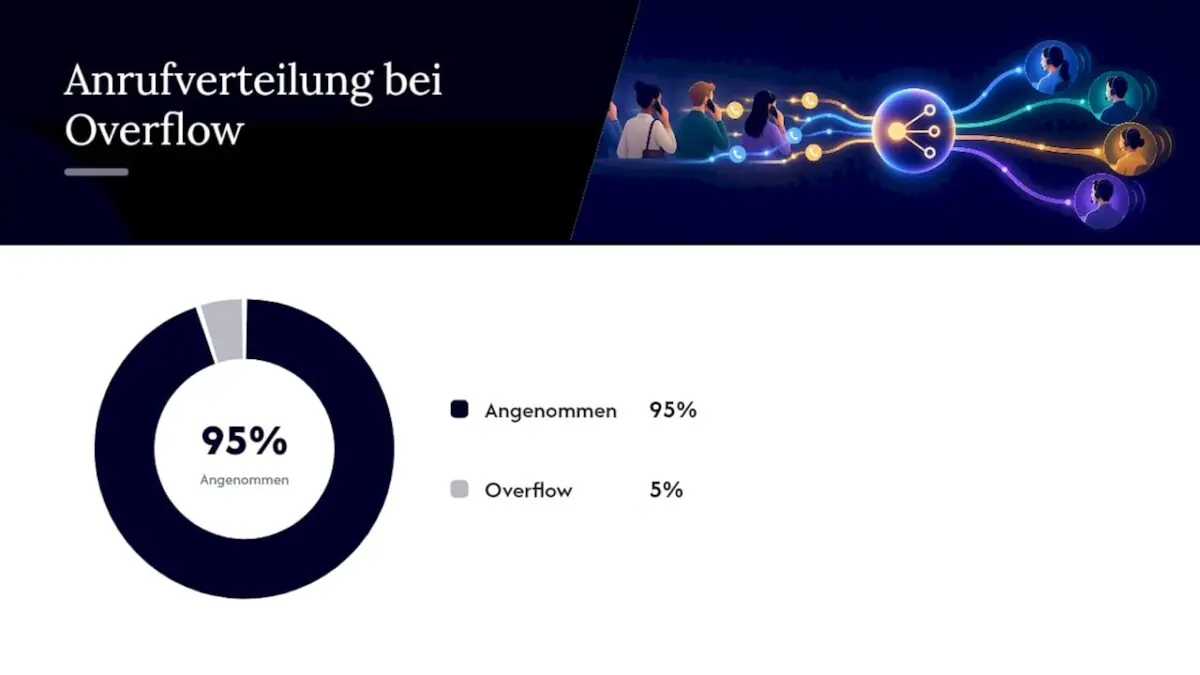
Die reine Answer‑Rate täuscht dabei oft eine bessere Lage vor, als tatsächlich besteht. Ein Callcenter kann 95 % der Anrufe annehmen und trotzdem massiv unter Druck stehen, wenn die Wartezeit für die übrigen 5 % ins Unermessliche steigt und genau diese Kunden die lautesten Beschwerden hinterlassen. Overflow‑Callcenter fungieren dabei als Sicherheitsnetz, das verpasste Interaktionen abfängt, bevor sie zu Umsatzverlust werden, wie Callin in seiner Analyse zu Overflow‑Callcentern beschreibt.
Betriebswirtschaftlich betrachtet ist Overflow kein technisches Randproblem, sondern ein Steuerungsthema auf Managementebene:
- Jeder verpasste Anruf ist ein potenziell verlorener Umsatz oder eine unbearbeitete Reklamation.
- Wiederholte Überlastung schädigt die Teammoral und erhöht die Fluktuation im Support.
- Unkontrollierter Overflow erschwert verlässliche Forecasts für die Personalplanung.
Routing‑ und Fallback‑Modelle: Wann welches Modell einsetzen?
Nicht jede Überlastsituation braucht dieselbe Antwort. Die Wahl des Routing‑Modells hängt davon ab, wie vorhersehbar der Peak ist und wie kritisch die Anfrage ist.
- Skill‑Routing leitet Anrufe an Mitarbeiter mit passender Qualifikation weiter, selbst wenn eine andere Queue frei ist. Das lohnt sich bei komplexen Produkten, bei denen ein Fehltransfer mehr Schaden anrichtet als eine kurze Wartezeit.
- Prioritätsrouting stuft Kunden nach Vertragswert, VIP‑Status oder Dringlichkeit ein. Ein Unternehmenskunde mit Serviceausfall sollte nie in derselben Warteschlange stehen wie eine allgemeine Produktfrage.
- Zeitbasierte Weiterleitung greift, sobald eine Wartezeitschwelle überschritten wird, etwa nach 90 Sekunden automatisch in eine Zweit‑Queue oder zu einem externen Partner umschalten.
- Warteschwellen‑Routing reagiert auf die Anzahl wartender Anrufer statt auf die Zeit. Das ist sinnvoll, wenn Sie Kapazitätsgrenzen pro Queue kennen und diese hart durchsetzen wollen.
Bei den Fallback‑Optionen unterscheiden sich interne Backup‑Queues, externe Overflow‑Services und Callback‑Systeme deutlich in Aufwand und Wirkung. Eine interne Backup‑Queue funktioniert nur, wenn dort tatsächlich freie, geschulte Kapazität wartet, was in der Praxis selten der Fall ist. Externe Overflow‑Partner skalieren dagegen unabhängig von der eigenen Personaldecke. Callback‑ oder Voicemail‑Lösungen mit klarem SLA, etwa Rückruf innerhalb von 30 Minuten, entlasten die Warteschlange sofort, verlangen aber eine feste Prozess‑Ownership: Wer ruft zurück, bis wann, und wer eskaliert, wenn das SLA reißt? Ohne diese Klärung verschwinden Rückrufversprechen in der Realität regelmäßig, wie die Fachliteratur zum Kundenkontakt‑Management mahnt.
Technologie‑Stack: ACD, IVR, SIP und KI‑Agenten im Overflow‑Fall
Die technische Basis jedes Anrufweiterleitung Systems ist die Automatic Call Distribution (ACD). Sie muss nicht nur verteilen, sondern in Echtzeit erkennen, wann eine Queue die definierte Kapazitätsgrenze überschreitet, und dann automatisch die passende Fallback‑Regel auslösen, statt Anrufer einfach unbegrenzt warten zu lassen.
Das IVR‑Design entscheidet, wie viel Volumen den Live‑Agenten überhaupt erreicht. Gut gebaute Self‑Service‑Menüs, etwa für Statusabfragen oder Terminverschiebungen, können einen relevanten Anteil der Routineanfragen abfangen, bevor sie in die Warteschlange gelangen. Diabolocom weist in seiner Analyse zu Call Center Overflow darauf hin, dass IVR‑Optimierung und KI‑gestützte virtuelle Agenten substanzielles Routinevolumen abfangen und so den Overflow-Druck spürbar senken.
Bei Overflow‑Nummern und SIP‑Konfigurationen lohnt ein genauer Blick auf die Telefonie‑Details. Gebührenfreie Nummern haben teils Einschränkungen, etwa fehlende Outbound‑Fähigkeit, was sie für bestimmte Rückruf‑Szenarien ungeeignet macht, wie Zendesk in seiner Dokumentation zu Overflow‑Routing beschreibt.
Wichtige Konfigurationsbausteine im Überblick:
- Fallback‑Queues mit automatisierten Nachrichten für Wartezeit‑Transparenz.
- Business‑Hours‑Regeln, die Overflow‑Ziele je nach Tageszeit unterschiedlich definieren.
- Kontextübergabe an Live‑Agenten, damit ein KI‑Agent gesammelte Informationen nicht verloren gehen lässt.
Profi‑Tipp: Testen Sie die Übergabe vom virtuellen Agenten zum Menschen nicht nur auf Funktionalität, sondern auf Informationsverlust. Ein Kunde, der seine Frage zweimal erklären muss, ist frustrierter als einer, der einfach länger gewartet hat.
KPIs und Reporting: Welche Kennzahlen Sie täglich brauchen
Overflow lässt sich nicht steuern, was nicht gemessen wird. Ein belastbares Kennzahlenset für die Optimierung Anrufannahme umfasst mindestens Offered Volume, Service Level, Average Speed of Answer (ASA), Abandon Rate, First Contact Resolution (FCR), Transfer Rate und die Overflow‑Rate selbst.
Die Fachliteratur zum Queueing‑Management empfiehlt, Overflow explizit als operatives Steuerungsproblem zu behandeln und nach Intervall, Queue, Skill und Kanal zu reporten, statt nur einen Tagesdurchschnitt zu betrachten. Ein stündlicher Blick zeigt, ob der Overflow an bestimmten Tageszeiten systematisch auftritt, während ein Event‑Reporting nach Kampagne aufdeckt, welche Marketingaktion die Warteschlange gesprengt hat.
| Kennzahl | Messintervall | Löst typischerweise aus |
|---|---|---|
| Service Level | Stündlich | Anpassung der Schichtbesetzung |
| ASA | Stündlich | Aktivierung von Fallback‑Queues |
| Abandon Rate | Täglich | Überprüfung der Warteschwellen |
| Overflow‑Rate | Nach Ereignis | Review der Routing‑Regeln |
| FCR | Wöchentlich | Schulungsbedarf bei Überlaufagenten |
Ein Detail wird häufig übersehen: Eine niedrige Abandon Rate bei gleichzeitig steigender Transfer Rate kann bedeuten, dass Anrufer zwar nicht auflegen, aber durch mehrere Queues geschleust werden, ohne dass ihr Problem gelöst wird. Genau davor warnt die Springer‑Analyse, wenn sie fordert, Overflow‑Performance nie allein an der Answer‑Rate zu bemessen, sondern Dispositionsdaten und Eskalationsregeln einzubeziehen. Ein tieferer Blick auf First Contact Resolution als Steuerungsgröße zeigt, wie sich dieser Zusammenhang in der Praxis messen lässt.
Workforce Planning, Forecasting und kurzfristige Skalierung
Strategisches Workforce Management (SWFM) verhindert einen erheblichen Teil des Overflows, bevor er überhaupt entsteht. Wer Volumen vorausschauend plant, muss seltener reaktiv eskalieren.
- Forecast‑Horizonte definieren. Ein Puffer von 10 bis 15 % über dem erwarteten Volumen fängt normale Schwankungen ab, ohne dauerhaft Überkapazität vorzuhalten.
- Saisonale Peaks 60 bis 90 Tage vorher planen. Diabolocom empfiehlt genau diesen Vorlauf, um Zusatzpersonal zu rekrutieren oder externe Kapazität vertraglich zu sichern, wie im Beitrag zu Call Center Overflow beschrieben.
- Abgestufte Engagement‑Modelle nutzen. Eine Mischung aus Vollzeit‑, Teilzeit‑ und On‑Demand‑Kräften erlaubt kurzfristiges Hoch‑ und Herunterfahren, ohne Festanstellungen zu riskieren.
- Überlaufagenten gezielt schulen. Spezialisiertes Training für Teams, die nur in Peak‑Zeiten aktiv werden, reduziert Transferquoten und wiederholte Kontakte deutlich.
Eine akademische Untersuchung zu strategischem Workforce Management zeigt, dass Smart‑Data‑Analytics und vorausschauende Personalplanung Überstunden reduzieren und die Personalstruktur verbessern, was das Overflow‑Risiko strukturell senkt, so die Studie zu Smart Data Analytics. Wer drei bis fünf Planungsszenarien testet und Überstundenreduktion als eigene Kennzahl verfolgt, erkennt schneller, welches Personalmodell tatsächlich trägt.
Praktische Implementierungs‑Checkliste: Konfiguration, Tests und Go‑Live
Bevor ein neues Overflow‑Setup live geht, lohnt eine strukturierte Abnahme. Diese Punkte sollten Sie vor dem Go‑Live durchlaufen:
- Geschäftszeiten in allen Systemen konsistent hinterlegen, inklusive Feiertagsregeln.
- Overflow‑Nummern technisch prüfen, insbesondere Outbound‑Fähigkeit bei gebührenfreien Rufnummern.
- Warteschwellen anhand historischer Abandon‑Daten kalibrieren, nicht anhand von Bauchgefühl.
- Callback‑Flows mit klarer Ownership definieren, inklusive Eskalationspfad bei SLA‑Bruch.
- Lasttests durchführen, die nicht nur Answer‑Rate, sondern auch Context‑Transfer‑Qualität prüfen.
- Reporting‑Dashboards vor dem ersten echten Peak validieren, nicht währenddessen.
Microsoft beschreibt in seiner Dokumentation zu Dynamics 365, wie sich Overflow‑Bedingungen für Voice, Chat und Messaging technisch konfigurieren lassen, inklusive automatisierter Fallback‑Nachrichten, siehe die Anleitung zur Overflow‑Verwaltung. Nach jedem größeren Peak gehört ein Post‑Peak Review dazu: Welche Schwellenwerte haben gehalten, wo kam es zu Häufungen von Repeat Contacts, und welche Regel muss vor dem nächsten Ereignis angepasst werden? Diese Anpassungszyklen sind der eigentliche Unterschied zwischen einem System, das einmal funktioniert, und einem, das dauerhaft trägt. Eine gute Grundlage für die Regelgestaltung liefert der Beitrag zu effizientem Anfragen‑Routing.
Wie aLIVE Support Anrufüberläufe praktisch übernimmt
Ein Outsourcing‑Partner wird für viele Unternehmen erst dann relevant, wenn die eigene Personaldecke wiederholt an ihre Grenzen stößt. Es werden ausgelagerte Kundensupport-Dienstleistungen über Telefon, E-Mail, Live-Chat und Social-Messaging-Kanäle wie WhatsApp und Facebook angeboten, die als Omnichannel-Leistung positioniert sind, nicht als isolierter Callcenter-Ersatz.
Die Prozesse folgen zertifizierten Standards nach ISO 9001, ISO 27001 und ISO 14001, was für Entscheider vor allem bei der Auswahl eines externen Partners relevant ist, wenn Datenschutz und Prozessqualität vertraglich abgesichert werden müssen. Es können eigene Support-Tools bereitgestellt oder bestehende Kundensysteme integriert werden, was die Übergabe von Kontext bei Overflow-Szenarien vereinfacht.
Ein datengestützter Ansatz beinhaltet das systematische Tracking von Interaktionen und Kennzahlen zur fortlaufenden Bewertung von Team- und Serviceleistungen. Für Callcenter-Manager, die Overflow auch nachträglich analysieren wollen, stellt die Kombination aus Kapazität und Reporting einen wichtigen Mehrwert eines externen Partners dar.
After‑hours‑Routing: Weiterleitung außerhalb der Geschäftszeiten
Ein Anruf um 22 Uhr braucht eine andere Antwort als einer um 14 Uhr, doch viele Unternehmen behandeln beide Fälle identisch und verschenken damit Vertrauen bei Kunden, die außerhalb der Kernzeiten anrufen.
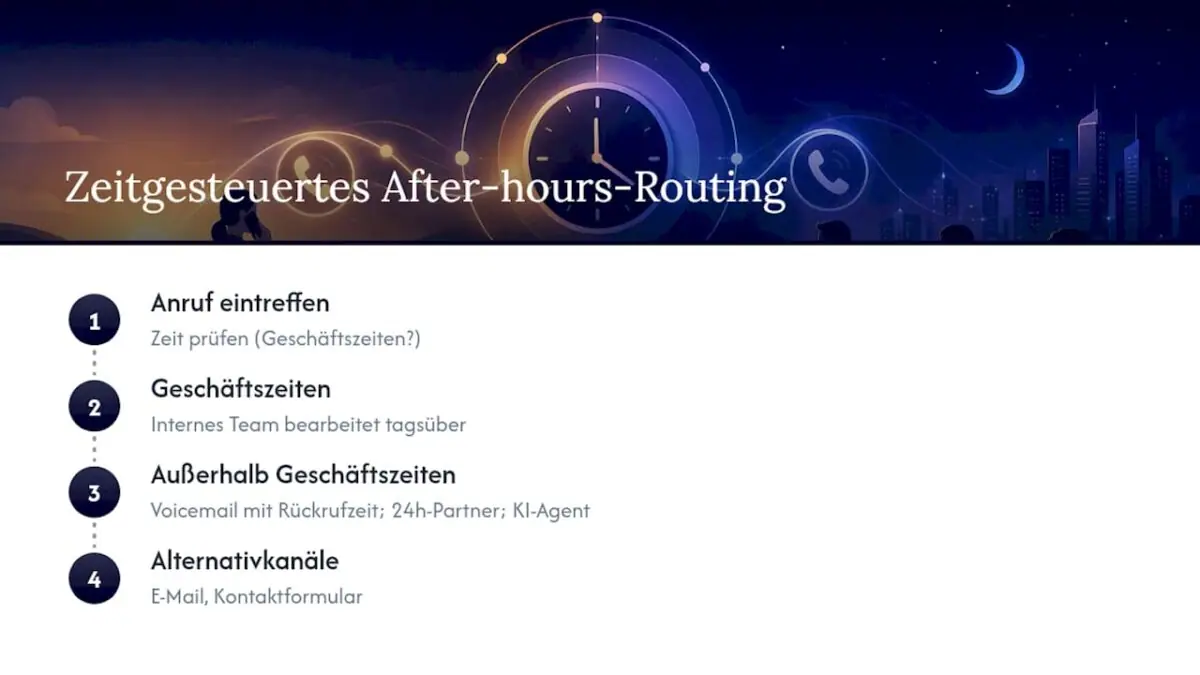
Die Basisoption ist eine klare Ansage mit Öffnungszeiten und alternativen Kontaktwegen, etwa E‑Mail oder ein Kontaktformular. Das reicht für viele kleinere Unternehmen, hinterlässt aber bei dringenden Anliegen einen schlechten Eindruck. Eine bessere Lösung sind zeitgesteuerte Overflow‑Ziele: Nach Geschäftsschluss leitet das ACD‑System Anrufe automatisch an eine Voicemail mit garantierter Rückrufzeit, an einen externen 24‑Stunden‑Partner oder an einen KI‑Agenten, der einfache Anfragen sofort löst und komplexe Fälle für den nächsten Werktag protokolliert.
Für Unternehmen mit internationalen Kunden oder E‑Commerce‑Geschäft lohnt sich oft ein hybrides Modell: Ein externer Partner übernimmt die Abdeckung außerhalb der Kernzeiten, während das interne Team die Hauptlast tagsüber trägt. Das vermeidet teure Nachtschichten für das eigene Team und stellt trotzdem sicher, dass kein Anruf einfach ins Leere läuft. Wichtig ist, dass die Business‑Hours‑Konfiguration in ACD, IVR und CRM konsistent hinterlegt ist, denn eine falsch eingestellte Zeitzone allein kann dazu führen, dass Kunden während echter Geschäftszeiten fälschlich in die After‑hours‑Schleife geraten.
Best Practices zur Optimierung des Call Overflow Managements
Die wirksamsten Maßnahmen sind selten spektakulär, sondern konsequent umgesetzte Grundlagenarbeit. Wer Overflow nachhaltig senken will, sollte diese Praktiken zur Routine machen, statt sie nur bei akuten Krisen zu aktivieren.
Regelmäßige Schwellenwert‑Reviews gehören dazu: Warteschwellen, die vor einem Jahr passend kalibriert waren, passen oft nicht mehr zum aktuellen Volumen oder zur veränderten Personalstärke. Ebenso wichtig ist die konsequente Trennung zwischen echten Notfällen und Routineanfragen im Prioritätsrouting, damit dringende Fälle nie in derselben Warteschlange wie allgemeine Produktfragen landen.
Ein häufig unterschätzter Hebel ist die Reduktion der Anrufursachen selbst. Wenn 20 % der Anrufe auf eine einzige, wiederkehrende Frage entfallen, etwa zu Lieferzeiten während einer Rabattaktion, lohnt sich eine proaktive Information per E‑Mail oder eine klare IVR‑Ansage mehr als jede zusätzliche Routing‑Regel. Der Beitrag zu effizienter Bearbeitung von Kundenanfragen geht auf genau diese Art der Volumensteuerung ein.
Auch die Kommunikation während der Wartezeit selbst zählt zu den Best Practices. Eine ehrliche Wartezeitangabe, die auch eingehalten wird, senkt die Abbruchrate stärker als beruhigende Musik ohne Information. Und schließlich sollten Routing‑Regeln nie isoliert vom Reporting betrachtet werden: Jede Regeländerung braucht einen Vorher‑Nachher‑Vergleich anhand der zentralen KPIs, sonst bleibt unklar, ob eine Anpassung tatsächlich gewirkt hat oder ob sich das Volumen aus anderen Gründen verändert hat.
Häufige Herausforderungen und deren Lösungen beim Call Overflow
Die drei wiederkehrenden Probleme im Overflow‑Management sind fast immer dieselben, egal in welcher Branche.
Falsch kalibrierte Schwellenwerte führen entweder zu verfrühten Transfers, die sekundäre Teams unnötig belasten, oder zu verspäteten Transfers, die Abbruchraten in die Höhe treiben. Die Lösung liegt in der Kalibrierung anhand historischer Abandon‑ und Bearbeitungszeit‑Daten statt fixer Pauschalwerte, ein Punkt, den die Fachliteratur ausdrücklich als Risikofaktor benennt.
Kontextverlust bei der Übergabe ist ein zweites, sehr konkretes Problem. Wenn ein Kunde vom IVR zum Callback‑System und dann zum Live‑Agenten wandert, ohne dass Informationen mitgenommen werden, muss er seine Situation mehrfach erklären. Das lässt sich nur durch technische Integration lösen, bei der CRM‑Daten und Interaktionsverlauf bei jedem Übergabepunkt automatisch mitwandern.
Fehlende Ownership bei Eskalationen ist die dritte Falle. Ein Callback‑Versprechen ohne benannten Verantwortlichen verschwindet in der Praxis regelmäßig zwischen Schichtwechseln. Klare Regeln, wer bis wann zurückruft und wer bei Überschreitung eskaliert, verhindern das.
Eine vierte, oft übersehene Herausforderung ist die Personalfluktuation bei Überlaufagenten selbst: Wer nur in Peak‑Zeiten arbeitet, baut seltener Erfahrung mit komplexen Fällen auf, was wiederum die Transferquote erhöht. Gezielte Schulung und feste Ansprechpartner für Rückfragen mildern dieses Problem deutlich.
Integration von Call Overflow mit CRM‑ und Ticket‑Systemen
Ein Overflow‑System, das ohne Anbindung an CRM und Ticketing arbeitet, produziert zwangsläufig Reibungsverluste. Der Kunde erlebt Brüche, der Agent arbeitet ohne Kontext, und das Reporting bleibt lückenhaft.
Die Integration sollte an mehreren Punkten greifen. Beim Erstkontakt sollte das System, sofern die Rufnummer erkannt wird, bereits vorhandene Kundendaten und offene Tickets anzeigen, bevor der Agent überhaupt das Gespräch beginnt. Bei einem Transfer in eine Overflow‑Queue oder zu einem externen Partner müssen Gesprächsnotizen, Dispositions‑Tags und bisherige Interaktionshistorie mitwandern, nicht nur die Telefonnummer.
Für Unternehmen, die einen externen Partner wie Alive für Call Center‑Unterstützung, Live‑Chat oder E‑Mail einsetzen, ist diese Integration der entscheidende Qualitätsfaktor. Ein Partner, der sich in bestehende CRM‑ und Ticketsysteme einklinken kann, statt eine separate Insellösung zu betreiben, verhindert genau die Kontextverluste, die Kunden als größten Frustpunkt bei Overflow‑Situationen empfinden. Auch die Dispositionsdaten aus dem Overflow‑Kanal sollten ins zentrale Reporting zurückfließen, damit Service Level und FCR unternehmensweit vergleichbar bleiben, nicht getrennt nach internem und externem Kanal geführt werden.
Ein praktischer Nebeneffekt guter Integration: Tickets, die während eines Overflow‑Peaks entstehen, lassen sich nachträglich taggen und auswerten. So erkennen Manager, welche Anrufursachen den nächsten Peak wahrscheinlich wieder auslösen werden.
Auswirkungen von Call Overflow auf Kundenzufriedenheit und Markenimage
Ein einzelner schlecht gehandhabter Overflow‑Vorfall bleibt selten folgenlos. Kunden, die lange warten, mehrfach transferiert werden oder ihre Frage wiederholt erklären müssen, bewerten das Erlebnis oft schlechter als die eigentliche Ursache des Problems.
Die Verbindung zwischen Warteschlangen‑Management und Kundenzufriedenheit ist in der Fachliteratur gut belegt: Reine Geschwindigkeitsoptimierung kann die Servicequalität sogar verschlechtern, wenn Transfers zu häufig oder an unterqualifizierte Teams erfolgen, wie die Analyse zum Kundenkontakt‑Management zeigt. Ein Kunde, der schnell, aber an die falsche Stelle weitergeleitet wird, ist am Ende unzufriedener als einer, der etwas länger auf den richtigen Ansprechpartner gewartet hat.
Für das Markenimage zählt zudem, wie öffentlich ein schlechtes Overflow‑Erlebnis wird. Ein frustrierter Kunde, der seine Wartezeit oder den wiederholten Transfer in sozialen Netzwerken teilt, erreicht potenziell tausende andere Kunden, die den Vorfall nie selbst erlebt haben. Genau deshalb lohnt sich Investition in Transparenz während der Wartezeit und in verlässliche Rückrufversprechen: Sie wirken nicht nur auf den einzelnen Anrufer, sondern auf die Wahrnehmung der gesamten Marke.
Positiv gewendet gilt dasselbe Prinzip: Ein Unternehmen, das auch in Peak‑Zeiten spürbar organisiert wirkt, etwa durch ehrliche Wartezeitangaben und funktionierende Rückrufe, gewinnt genau in diesen Stresssituationen oft mehr Vertrauen als im ruhigen Alltagsbetrieb.
Schulungen für Mitarbeiter im Umgang mit Overflow‑Situationen
Technik allein löst kein Overflow‑Problem, wenn die Mitarbeiter im Umgang mit den entstehenden Sondersituationen nicht geschult sind. Zwei Gruppen brauchen dabei unterschiedliche Trainingsinhalte.
Die reguläre Belegschaft muss lernen, wie sie mit Kunden umgeht, die bereits eine lange Wartezeit oder einen Transfer hinter sich haben. Diese Kunden sind häufig ungeduldiger, und ein Agent, der das direkt anspricht, statt es zu ignorieren, entschärft die Situation meist schneller als ein rein sachlicher Gesprächseinstieg.
Überlaufagenten, ob intern rotierend oder von einem externen Partner gestellt, brauchen zusätzlich eine gezielte Einarbeitung in die häufigsten Anrufursachen und in die verwendeten Systeme. Diabolocom betont in seiner Analyse zu Call Center Overflow, dass spezialisierte Schulung für genau diese Gruppe die Transferquote und die Zahl wiederholter Kontakte deutlich senkt. Wer nur gelegentlich in Peak‑Zeiten aushilft, braucht kürzere, aber intensivere Auffrischungen statt einer einmaligen Grundschulung.
Ein oft übergangener Trainingsaspekt ist die Dokumentationsdisziplin: Wenn Überlaufagenten Dispositions‑Tags und Gesprächsnotizen weniger sorgfältig pflegen als die Stammbelegschaft, entstehen genau jene Repeat Contacts, vor denen die Fachliteratur zum Kundenkontakt‑Management warnt. Regelmäßige Qualitätskontrollen anhand von Gesprächsaufzeichnungen und Dispositionsdaten, nicht nur anhand der Answer‑Rate, halten dieses Risiko in Grenzen.
Redaktionelle Einschätzung: Wann Outsourcing gegenüber technischer Aufrüstung bevorzugt wird
Die Entscheidung zwischen mehr Technik und einem externen Partner läuft in der Praxis auf eine Achse hinaus: Zeit bis zur Wirkung gegen Investitionsbedarf. Eine neue ACD‑Konfiguration oder ein KI‑Agent kann Wochen bis Monate bis zur vollen Wirkung brauchen und verlangt internes Know‑how, das viele Teams schlicht nicht dauerhaft vorhalten wollen.
Outsourcing lohnt sich vor allem dort, wo Overflow wiederkehrend, nicht einmalig ist, wo interne Workforce‑Management‑Kapazität fehlt, oder wo saisonale Skalierung schneller gebraucht wird, als eine eigene Rekrutierung leisten kann. Wer diese drei Indikatoren bei sich erkennt, sollte Outsourcing nicht als Notlösung, sondern als strukturelle Antwort behandeln.
— Markus
Overflow‑Kapazität ohne eigenen Personalaufbau
Wer die in diesem Artikel beschriebenen Routing‑Regeln und KPI‑Systeme aufgebaut hat, aber trotzdem regelmäßig an Kapazitätsgrenzen stößt, braucht keine weitere Software, sondern zusätzliche Hände am Telefon. Ein externer Partner kann diese Rolle als Erweiterung des bestehenden Teams übernehmen und bringt etablierte Prozesse für Peak-Zeiten mit, statt mühsam neue Agenten einzuarbeiten.
Für Overflow‑Szenarien passt die Call Center‑Unterstützung am direktesten, da sie Inbound‑Spitzen ohne eigene Rekrutierung auffängt. Wer Overflow zusätzlich über Chat oder E‑Mail abfedern will, findet passende Bausteine in der Live‑Chat‑Unterstützung und der E‑Mail‑Unterstützung. Beim Onboarding werden Geschäftszeiten, Eskalationsregeln und Reporting‑Formate gemeinsam mit dem bestehenden Team abgestimmt, sodass die Übergabe von Kontext von Anfang an funktioniert. Wer die eigene Overflow‑Situation konkret besprechen möchte, nimmt am besten direkt Kontakt auf.
Quellen
Für alle, die tiefer in die Materie einsteigen wollen:
- Queueing und Kundenkontakt‑Management (Springer)
- Manage overflow of work items in queues (Microsoft)
- Smart Data Analytics: Mit strategischem Workforce Management (Akademische Studie)
FAQ
Was bedeutet die 80/20‑Regel im Callcenter?
Die 80/20‑Regel beschreibt ein gängiges Service‑Level‑Ziel: 80 % der Anrufe sollen innerhalb von 20 Sekunden angenommen werden. Sie ist ein Ausgangswert, kein Naturgesetz, und sollte an das eigene Anrufvolumen und die Kundenerwartung angepasst werden, wie der Beitrag zu Servicelevel im Callcenter genauer erklärt.
Welche Position steht in einem Callcenter ganz oben?
Die höchste operative Position ist in der Regel der Contact Center Director oder Head of Customer Operations, der für Personalstrategie, Technologie und KPI‑Verantwortung zuständig ist. Darunter folgen meist Teamleiter und Workforce‑Management‑Spezialisten, die das Tagesgeschäft steuern.
Wie sieht ein typischer Call Flow bei Overflow aus?
Ein Anruf trifft zunächst auf das IVR, das erste Self‑Service‑Optionen anbietet und den Anrufer klassifiziert. Wird die Warteschwelle der Ziel‑Queue überschritten, greift die Overflow‑Regel und leitet an eine Backup‑Queue, einen externen Partner oder ein Callback‑System mit definiertem SLA weiter, wobei der gesamte Kontext im Idealfall mitwandert.
Wie geht man mit hohem Anrufvolumen um?
Kurzfristig helfen zeitbasierte Overflow‑Regeln, Callback‑Angebote und externe Fallback‑Kapazität, um Abbruchraten zu senken. Mittelfristig senkt vorausschauendes Workforce Planning mit 60 bis 90 Tagen Vorlauf für saisonale Peaks das Risiko, überhaupt in eine Überlastsituation zu geraten, wie Diabolocom in seiner Analyse beschreibt.
Was kostet die Call Center‑Unterstützung von Alive?
Die Preise für die Call Center‑Unterstützung sind nicht öffentlich gelistet und richten sich nach individuellem Bedarf. Aktuelle Konditionen erhalten Interessenten direkt über eine Anfrage bei Alive.
Empfehlungen
Wir betreiben Kundenservice für Unternehmen aus regulierten Branchen – von Magdeburg, Quedlinburg, Sibiu und Arad aus. Hier teilen wir, was wir im Tagesgeschäft lernen.
Verwandte Artikel.