Eskalationsmatrix im Kundenservice: In 60 Sekunden zur Klarheit
Entdecken Sie, wie eine Eskalationsmatrix im Kundenservice die Reaktionszeiten verbessert und Klarheit für Ihr Team schafft.
Eine Eskalationsmatrix beantwortet genau drei Fragen: Wer übernimmt den Fall, bis wann muss reagiert werden, und was passiert, wenn die Lösung ausbleibt. Genau diese Kürze macht eine Matrix nutzbar – sie soll in unter einer Minute lesbar sein, nicht in einem zehnseitigen Prozesshandbuch verschwinden. Die Kernspalten sind immer gleich: Severity, Owner, Response Time. Wenn Sie heute noch keine Matrix haben, reicht dieser Rahmen als Sofortmaßnahme:
- Critical: Teamleitung, Reaktion in 15 Minuten
- High: Senior-Agent, Reaktion in einer Geschäftsstunde
- Medium: Standard-Team, Reaktion binnen eines Geschäftstags
- Low: Warteschlange, Reaktion binnen drei Geschäftstagen
Bei aLIVE Support laufen genau solche Raster täglich in Omnichannel-Umgebungen, in denen Telefon, Chat und Social Messaging gleichzeitig eskalieren können.
Wichtige Erkenntnisse
Eine Eskalationsmatrix funktioniert nur, wenn sie in unter einer Minute lesbar ist, klare Severity-Kriterien enthält und jede Eskalation in ein nachverfolgbares Ticket überführt.
| Thema | Details |
|---|---|
| Vier-Spalten-Prinzip | Severity, Issue Type, Owner und Response Time reichen für die meisten Support-Teams aus. |
| Rollen statt Namen | Tragen Sie Funktionen wie „On-call-Engineer“ ein, damit die Matrix Personalwechsel überlebt. |
| Kennzahlen im Blick behalten | Eskalationsrate zwischen 8 und 15 % und Ablehnungsrate zwischen 10 und 20 % gelten als Orientierung. |
| Pilot vor Rollout | Testen Sie neue Severity-Grenzen zwei Wochen in einer Schicht, bevor Sie das ganze Team umstellen. |
| Externe Unterstützung nutzen | Alive integriert Eskalationsmatrizen direkt in Omnichannel-Betrieb, SLA-Reporting und bestehende CRM-Systeme. |
Was ist eine Eskalationsmatrix im Kundenservice?
Eine Eskalationsmatrix ist ein tabellarisches Regelwerk, das jedem Support-Problem eine Schweregradstufe, eine verantwortliche Rolle und ein festes Zeitfenster zuordnet. Sie unterscheidet sich damit deutlich vom allgemeinen Eskalationsmanagement, das eher die Kultur und Haltung im Team beschreibt, und auch von der SLA-Dokumentation, die vertragliche Reaktionszeiten gegenüber Kunden festhält. Die Matrix ist das operative Werkzeug dazwischen: Sie übersetzt SLA-Zusagen in konkrete interne Handlungsanweisungen.
Genau hier liegt der Unterschied, den viele Teams unterschätzen. Ein SLA sagt dem Kunden, was er erwarten darf. Die Matrix sagt dem Mitarbeiter, was er in diesem Moment tun muss.
Eine Matrix, die auf eine einzige Seite passt, wird tatsächlich benutzt. Sobald sie auf mehrere Reiter oder Unterseiten wächst, sinkt die Nutzungswahrscheinlichkeit rapide, weil niemand in einem hitzigen Kundengespräch fünf Klicks für die richtige Regel übrig hat. Deshalb gilt für jede funktionierende Eskalationsmatrix im Kundenservice dieselbe Faustregel:
- Vier Spalten reichen fast immer aus
- Rollen statt Namen eintragen, sonst veraltet die Matrix bei jeder Personalveränderung
- Reaktionszeiten in Geschäftsstunden statt Kalenderstunden angeben
- Eine gedruckte oder angepinnte Version schlägt jedes Wiki, das niemand öffnet
Wie die Matrix praktisch funktioniert: Severity, Owner, Response Time
Die Formel hinter jeder brauchbaren Matrix hat vier Bestandteile: Severity, Issue Type, Owner und Response Time. Jede Spalte erfüllt eine eigene Aufgabe. Severity entscheidet über die Dringlichkeit, Issue Type sortiert das Problem in eine bekannte Kategorie ein, Owner benennt die zuständige Rolle, und Response Time setzt die Uhr in Gang. Fehlt eine der vier Spalten, bricht die Kette an genau dieser Stelle zusammen.
Severity-Stufen müssen beobachtbar sein, nicht interpretierbar. „Kritisch, weil der Kunde unzufrieden wirkt“ ist keine Definition, „Kritisch, weil der Zahlungsprozess für alle Nutzer ausfällt“ schon.
| Severity | Beispiel | Owner | Response Time |
|---|---|---|---|
| Critical | Zahlungssystem oder Login für alle Nutzer down | Teamleitung / On-call-Engineering | 15 Minuten |
| High | Kernfunktion für einzelne Kunden gestört | Senior-Support-Agent | 1 Geschäftsstunde |
| Medium | Fehler mit Workaround, kein Datenverlust | Standard-Support-Team | 1 Geschäftstag |
| Low | Kosmetischer Fehler, Feature-Wunsch | Warteschlange / Backlog | 3 Geschäftstage |
Diese Vier-Spalten-Struktur mit konkreten Zeitfenstern hat sich in der Praxis durchgesetzt, weil sie Streit über Zuständigkeiten von vornherein ausschließt. Eine Eskalation ist erst dann wirklich abgeschlossen, wenn sie ein nachverfolgbares Ticket im Entwicklungssystem erzeugt hat, das per Zwei-Wege-Link mit dem ursprünglichen Support-Fall verbunden bleibt. Ohne diesen Rücklauf verschwinden Tier-3-Fälle im System, und der Kunde bekommt nie ein Update.
Profi-Tipp: Verlinken Sie jedes eskalierte Ticket doppelt: einmal vom Support-System zum Engineering-Issue, einmal zurück. So sieht der Agent den Status ohne Nachfrage bei der Fachabteilung.
Typen von Eskalationen: Hierarchisch, funktional, automatisch, prioritätsbasiert
Nicht jedes Team braucht dieselbe Eskalationslogik. Vier Grundtypen decken die meisten Fälle ab, und Mischformen sind in der Praxis eher die Regel als die Ausnahme.
- Hierarchisch: Der Fall wandert nach oben, von Tier 1 über Tier 2 zu Tier 3 oder zur Führungsebene. Passt zu klassischen Support-Organisationen mit klarer Befehlskette.
- Funktional: Der Fall wechselt die Abteilung, etwa von Support zu Engineering oder zum Billing-Team, ohne dass eine höhere Hierarchieebene eingebunden wird. Sinnvoll, wenn das Problem fachlich, nicht rangbedingt gelöst werden muss.
- Automatisch: Ein System löst die Eskalation aus, sobald ein Zeitfenster überschritten ist, etwa wenn ein kritisches Ticket 15 Minuten unbeantwortet bleibt. Notwendig für Teams mit hohem Ticketvolumen, bei denen manuelle Kontrolle nicht skaliert.
- Prioritätsbasiert: Die Reihenfolge richtet sich nach Kundenwert oder Vertragsstufe, unabhängig vom technischen Schweregrad. Verbreitet im B2B-Enterprise-Support mit gestaffelten Servicelevels.
Ein kleines SaaS-Team kommt meist mit hierarchischer plus automatischer Eskalation aus. Wächst die Organisation, kommt die funktionale Variante dazu, sobald einzelne Abteilungen eigenständig entscheiden dürfen. Enterprise-Kunden erwarten fast immer eine prioritätsbasierte Komponente obendrauf.
So erstellen Sie in fünf Schritten eine funktionierende Matrix
Eine Eskalationsmatrix entsteht am besten in einem einzigen Workshop, nicht über Monate verteilt. Diese Reihenfolge hat sich bewährt:
- Problemkategorien sammeln. Gehen Sie die letzten 100 bis 200 Tickets durch und clustern Sie sie nach Thema: Zahlungsfehler, Login-Probleme, Datenverlust, Feature-Fragen. Fünf bis acht Kategorien reichen fast immer.
- Severity-Kriterien festlegen. Formulieren Sie für jede Kategorie, was „Critical“ konkret bedeutet. Vermeiden Sie subjektive Formulierungen wie „schwerwiegend“ ohne Beispiel.
- Rollen statt Personen definieren. Tragen Sie „On-call-Engineer“ oder „Team Lead Tier 2“ ein, niemals einen Namen. Namen wechseln, Rollen bleiben.
- Reaktionsfenster setzen. Orientieren Sie sich an den bestehenden SLA-Zusagen gegenüber Kunden und rechnen Sie einen internen Puffer ein.
- In das Ticketing-Tool einbauen. Legen Sie Severity als Pflichtfeld mit Dropdown an, erstellen Sie gespeicherte Ansichten pro Stufe und richten Sie automatische Zuweisungen an die passende Rolle ein.
Für die technische Umsetzung reicht meist ein Dropdown-Feld für Severity, eine gespeicherte Ansicht pro Owner-Rolle und eine Regel, die bei Zeitüberschreitung automatisch eine Benachrichtigung auslöst. Helpdesk-Systeme mit integrierten Eskalationsfunktionen machen genau diese Automatisierung mit wenigen Klicks möglich, ohne dass Agenten die Matrix manuell nachschlagen müssen.
Bevor die Matrix im gesamten Team live geht, lohnt sich ein zweiwöchiger Pilot mit einer einzelnen Schicht oder einem einzelnen Kanal:
- Pilotgruppe auswählen und Startdatum kommunizieren
- Nach einer Woche kurzes Feedback einholen: Welche Severity-Grenzen fühlten sich falsch an?
- Reaktionszeiten anpassen, falls sie systematisch verpasst wurden
- Erst nach der Anpassung auf das gesamte Team ausrollen
Profi-Tipp: Lassen Sie die Pilotgruppe die Matrix bewusst „missbrauchen“ – also absichtlich Grenzfälle einordnen. So finden Sie Lücken, bevor der echte Ernstfall sie aufdeckt.
Mehr zur praktischen Einbettung solcher Prozesse in bestehende Abläufe finden Sie im Leitfaden zu Support-Prozesse optimieren für den Mittelstand.
Vorlage und Beispiele für unterschiedliche Teamgrößen
Eine Matrix zum direkten Kopieren braucht keine Software, nur vier Spalten in einer Tabelle:
Severity | Issue Type | Owner | Response Time
Damit lässt sich sofort eine eigene Version aufbauen, angepasst an Teamgröße und Branche.
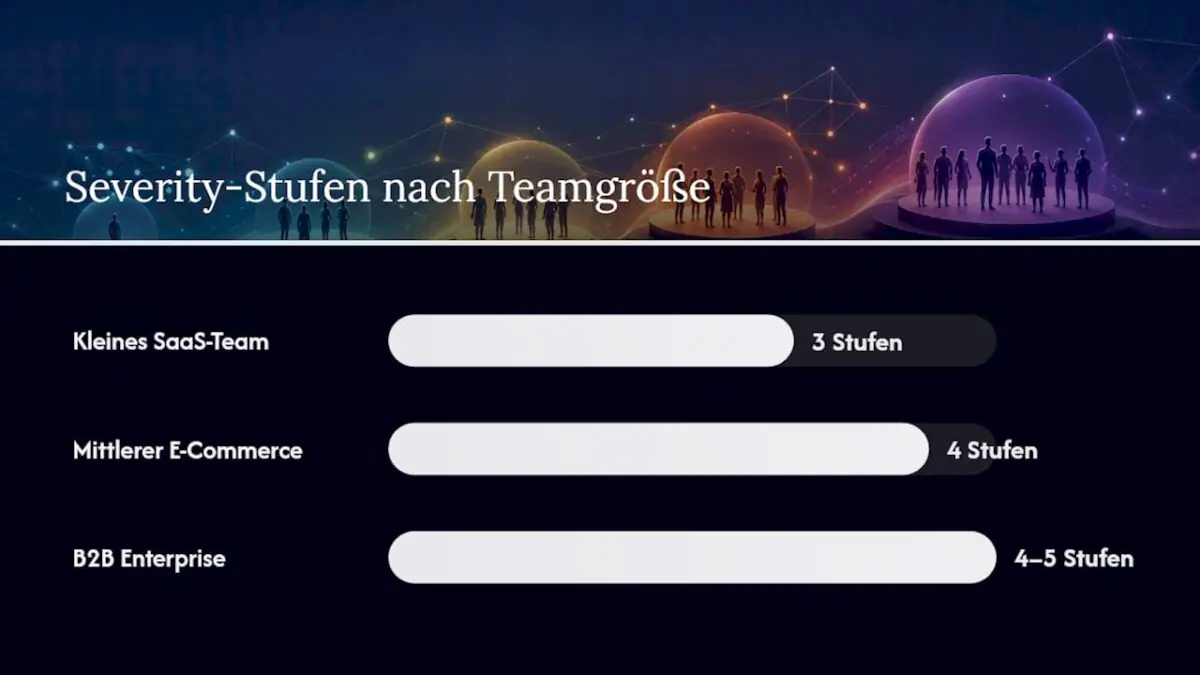
| Unternehmenstyp | Severity-Stufen | Owner-Struktur | Besonderheit |
|---|---|---|---|
| Kleines SaaS-Team | 3 Stufen (Critical, Normal, Low) | Ein Tier, Gründer als Eskalationsstufe | Sehr kurze Matrix, oft nur eine Zeile pro Stufe |
| Mittlerer E-Commerce | 4 Stufen | Tier 1, Tier 2, Fulfillment-Team | Zusätzliche Spalte für Bestellstatus nötig |
| B2B Enterprise | 4 bis 5 Stufen inkl. Prioritätskunden | Tier 1 bis 3, Customer Success Manager, Führungsebene | Separate Spur für Top-Accounts mit eigenem SLA |
Ein kleines SaaS-Team braucht selten mehr als drei Zeilen, weil ohnehin fast jeder im Unternehmen mehrere Rollen übernimmt. Ein mittelgroßer E-Commerce-Betrieb ergänzt die Matrix meist um eine Spalte für den Bestellstatus, weil Versandprobleme eine eigene Eskalationslogik brauchen. Enterprise-Teams mit vertraglich zugesicherten Servicelevels fügen für Top-Kunden eine eigene Spur mit engeren Zeitfenstern hinzu.
Wollen Sie die Vorlage kürzen, streichen Sie zuerst die Low-Stufe und lassen Sie diese Fälle in eine allgemeine Warteschlange laufen. Wollen Sie erweitern, fügen Sie eine Spalte für „Eskaliert an“ hinzu, sobald mehrere Abteilungen gleichzeitig involviert sein können.
Wie sieht eine saubere Übergabe zwischen den Rollen aus?
Eine Eskalation scheitert selten an der Matrix selbst, sondern an einer schlecht formulierten Übergabe. Ein Kontext-first-Format reduziert Rückfragen erheblich: Die erste Zeile jeder Eskalationsnachricht sollte immer vier Dinge klären, in dieser Reihenfolge:
- Was ist kaputt (in einem Satz, ohne Fachjargon)
- Wer ist betroffen (ein Kunde, ein Segment, alle Nutzer)
- Was wurde bereits versucht
- Was wird konkret vom Empfänger benötigt
Bevor Sie überhaupt eskalieren, hilft ein kurzer Vier-Fragen-Test: Ist das Problem für den Kunden geschäftskritisch? Übersteigt es Ihre eigene Entscheidungsbefugnis? Wurde die Standardlösung bereits ohne Erfolg versucht? Wird eine Antwort innerhalb der nächsten Stunde erwartet? Zwei oder mehr Ja-Antworten rechtfertigen die Eskalation.
Profi-Tipp: Schreiben Sie die vier Fragen als Checkliste direkt ins Eskalationsformular. Agenten, die sie beantworten müssen, eskalieren gezielter statt reflexhaft.
Rollenklarheit gehört ebenso dazu: Tier 1 löst, Tier 2 vertieft, der On-call-Engineer behebt technische Ursachen, und der Customer Success Manager hält den Kunden informiert. Mehr zu diesen Übergabepunkten liefert der Beitrag Was ist Support Escalation?
Welche Kennzahlen zeigen, ob die Matrix funktioniert?
Eine Matrix ohne Messung ist nur ein Dokument. Vier Kennzahlen zeigen, ob sie tatsächlich greift:
- Eskalationsrate: Anteil der Tickets, die eskaliert werden, gemessen am Gesamtvolumen
- Ablehnungsrate: Anteil der Eskalationen, die zurückgewiesen werden, weil sie die Kriterien nicht erfüllten
- Time-to-escalate: Zeit zwischen Ticketeingang und tatsächlicher Eskalation
- CSAT-Vergleich: Kundenzufriedenheit bei eskalierten versus nicht eskalierten Fällen
Eine gesunde Eskalationsrate liegt meist zwischen 8 und 15 %, die Ablehnungsrate meist zwischen 10 und 20 %. Liegt die Eskalationsrate deutlich darunter, horten Agenten wahrscheinlich Probleme, statt sie weiterzugeben. Liegt sie deutlich darüber, wälzt das Team Verantwortung ab, die eigentlich in Tier 1 gelöst werden könnte.
Kalibrieren Sie in kleinen Schritten: Ändern Sie eine Severity-Grenze, beobachten Sie zwei Wochen im Dashboard, passen Sie erneut an. Ein Wochenreport mit diesen vier Zahlen reicht, um Fehlentwicklungen früh zu erkennen.
Wie integriert aLIVE Support Eskalationspfade in der Praxis?
Bei Alive laufen Eskalationsmatrizen nicht als theoretisches Konzept, sondern als Teil des täglichen Omnichannel-Betriebs über Telefon, E-Mail, Live-Chat und Social Messaging. Zertifizierungen nach ISO 9001 und ISO 27001 verpflichten zu dokumentierten, nachweisbaren Eskalationsprozessen, nicht zu Ad-hoc-Entscheidungen. Datengestützte Kalibrierung, also die laufende Anpassung von Severity-Grenzen anhand echter Ticketdaten, gehört zum Kern der Zusammenarbeit mit Kunden.
Vertiefende Praxisbeispiele zu Eskalationswegen liefert der Beitrag Beispiele für Kundenanfragen-Management.
Warum einfache Regeln besser funktionieren als komplexe Prozesse
Die verbreitete Annahme, eine Eskalationsmatrix müsse jeden Sonderfall abdecken, führt fast immer zum Gegenteil des gewünschten Effekts. Je mehr Ausnahmen eine Matrix enthält, desto seltener wird sie im Ernstfall überhaupt geöffnet. Support-Teams, die ich für besonders wirksam halte, arbeiten mit vier Severity-Stufen und akzeptieren bewusst, dass fünf Prozent der Fälle nicht perfekt hineinpassen.
Was viele Teams zudem unterschätzen: Die Matrix selbst ist die kleinere Herausforderung. Die eigentliche Arbeit beginnt bei der Kalibrierung, also bei der ehrlichen Frage, ob die Eskalationsrate zu niedrig ist, weil Agenten Probleme horten, oder zu hoch, weil sie Verantwortung abwälzen. Diese Zahl ehrlich zu lesen, verlangt mehr Disziplin als das Aufsetzen der Tabelle selbst.
Mein Rat für die ersten 30 Tage: Bauen Sie die Matrix bewusst zu klein, nicht zu groß. Eine unterkomplexe Matrix lässt sich in einer Woche erweitern. Eine überkomplexe Matrix wird nie wieder verschlankt, weil niemand die Verantwortung für das Streichen übernehmen will.
— Markus
So unterstützt aLIVE Support den Aufbau Ihrer Eskalationsmatrix
Alive ist die Alternative zum internen Aufbau eines eigenen Eskalationsteams: Statt monatelang eigene Tier-Strukturen, On-call-Rotationen und Reporting-Dashboards zu entwickeln, übernimmt Alive Omnichannel-Integration über Telefon, E-Mail, Live-Chat und Social-Messaging-Kanäle wie WhatsApp oder Facebook mit bereits eingespielten Eskalationspfaden.
Die Zusammenarbeit umfasst On-call-Rollen für kritische Fälle, laufendes SLA-Reporting und Zertifizierungen nach ISO 9001, ISO 27001 und ISO 14001, die dokumentierte Eskalationsprozesse ohnehin voraussetzen. Bestehende Ticketing- und CRM-Systeme lassen sich anbinden, sodass keine Matrix doppelt gepflegt werden muss. Wer die eigene Eskalationslogik nicht von null aufbauen will, sondern auf ein eingespieltes Setup zurückgreifen möchte, findet auf der aLIVE Support Website einen direkten Weg zur Kontaktaufnahme und einem unverbindlichen Erstgespräch.
Quellen
- The Escalation Matrix Support Teams Actually Use
- Eskalation: Wann nach oben weitergeben statt selbst lösen
- The Escalation Matrix: Best Practices and Going Beyond
Empfehlung
Wir betreiben Kundenservice für Unternehmen aus regulierten Branchen – von Magdeburg, Quedlinburg, Sibiu und Arad aus. Hier teilen wir, was wir im Tagesgeschäft lernen.
Verwandte Artikel.